了解FlashAttention-1、2、3、4
已有的几种大模型上下文支持情况:
厂商 | 代表模型系列 | 官方标称上下文长度 | 换算成中文 | 核心标签 / 特点 |
Gemini 1.5 Pro / 3 Pro Gemini 1.5 Flash / 3.5 Flash | 2M ~ 10M (200万~1000万 Token) | 150万 ~ 750万字 | 长上下文绝对王者 可吞下一整年聊天记录、数十小时音频或长视频 | |
Anthropic | Claude 4.6 / 5 系列 (包括 Sonnet / Opus) | 1M (API 阶段) (常用 200k 基础窗口) | 约 70万 ~ 80万字 | 地表最强编程与 Agent 代码重构、复杂逻辑推理、计算机操作 |
OpenAI | GPT-4o / GPT-5 系列 o1 / o3 系列 (Reasoning) | 128k ~ 400k | 约 9万 ~ 30万字 | 全能、高精度推理 o系列主打“原生思考”,虽然上下文不是最大,但复杂任务极其精准 |
DeepSeek | DeepSeek-V3 / R1 / V4 (包含 Chat 与 Reasoner) | 128k ~ 1M | 约 9万 ~ 75万字 | 性价比与推理双神 极低成本实现媲美顶尖模型的长文本与强逻辑推理 |
Alibaba | 通义千问 Qwen3 系列 (如 Qwen3-Max) | 256k ~ 1M | 约 20万 ~ 75万字 | 开源社区领头羊 基座能力极强,多语言与长文本支持极其稳定 |
一 标准的 Attention:
在 Transformer 架构中,标准注意力机制(Standard Attention),通常指的就是 Transformer 原作用于自注意力(Self-Attention)的缩放点积注意力(Scaled Dot-Product Attention)。
其核心思想是:从一句话的上下文中,为当前单词寻找与之最相关的其他单词,并赋予更高的权重。
下面我们从数学公式、计算步骤以及硬件执行的痛点这三个维度,详细拆解标准 Attention 的做法。
1.1、关键参数:$K = X \times W_K$、d_model、d_k
1.1.1、$W_K$ 的物理形状
大模型的参数量之所以动辄几百亿、上千亿,就是因为由无数个像 $W_K$ 这样的矩阵叠加而成的。在标准的 Transformer 架构中:输入维度 $d_{\text{model}}$(隐层维度): 指的是词向量进入注意力层之前的标准长度(比如 Llama-3-8B 模型中,这个值是 4096)。输出维度 $d_k$(特征维度): 指的是我们希望提取出来的 Key 特征长度(通常是 128)。因此,一个单头注意力(Single-Head Attention)的 $W_K$ 矩阵,其形状为:
$\text{形状} = [d_{\text{model}} \times d_k]$
以具体数字为例:如果$d_{\text{model}} = 4096$(隐藏层维度 hidden_size),d_k = 128$,那么$W_K 就是一个$4096 \times 128$的大矩阵。它里面包含了$4096 \times 128 = 524,288$(约 52 万)个浮点数(如 FP16 或 BF16 格式)。2. W_K的内部长什么样?(空间转换的“投影机”)如果把W_K 矩阵打印出来,它其实就是一块密密麻麻的数字:
$$ W_K = \begin{bmatrix} 0.012 & -0.045 & \dots & 0.112 \\ -0.089 & 0.023 & \dots & -0.005 \\ \vdots & \vdots & \ddots & \vdots \\ 0.054 & -0.121 & \dots & 0.078 \end{bmatrix}_{4096 \times 128} $$
它的数学本质:空间线性投影,在几何上,输入向量 X(长度 4096)乘以 W_K 矩阵,本质上是做了一次空间降维和线性变换。
- 输入X(1 x 4096$):$包含了这个词极其庞杂的各种全局信息。
- 乘法过程。$X \times W_K$:4096 维的向量与 W_K的 128 列逐一做点积。
- 输出K($1 \times 128$): 被精简、浓缩成了专门用来做“相关性匹配”的 128 维特征。
1.1.2、$d_{\text{model}}$ 与 $d_k$ 有什么区别?
在大模型(Transformer)的架构设计中,有两个维度至关重要:$d_{\text{model}}$(隐层维度,如 4096) 和 $d_k$(单头特征维度,如 128)。
很多人容易把它们混淆。一个非常直观的理解视角是:$d_{\text{model}}$ 是输入世界自带的“客观全息画像”,而 $d_k$ 是大模型因任务而异的“主观观察对焦”。
1. $d_{\text{model}}$(如 4096):词的全局百科全书
大模型不能直接读文字,每个词(Token)进去后都会被转化为一串高维数字。
- 角色:静态全局表征空间。
- 本质:它是通用的、客观的。无论是拿模型来写代码还是写小说,输入同一个词(比如 "Pointer"),它在 $d_{\text{model}} = 4096$ 维的空间里包含的信息广度完全一样。
2. $d_k$(如 128):注意力头的专项对焦
当数据流从通用的 $d_{\text{model}}$ 跨入自注意力层(Attention Layer)时,分化开始了。4096 维的“全息画像”会通过一个权重矩阵($W_K$),被精简、投影成数个独立的 $d_k = 128$ 维向量。
- 角色:动态局部特征投影。
- 本质:它是专一的、主观的。不同的模型,关注的 $d_k$ 维度截然不同。
- 类比:去相亲角时大妈手里的专项比对指标。大妈不需要看你复杂的高数成绩或体检报告,她只对焦提取 3 个核心指标:
[年龄, 收入, 房产]。
3. 编程模型 vs 写作模型:$d_k$ 的降维打击
我们可以通过两个完全不同训练导向的模型,来看看它们在 $d_k$ 阶段是如何分道的:
假设输入同一个词:"Pointer"(指针/指向者)。
在进入模型之初,两者的 $d_{\text{model}} = 4096$ 完全一致,包含了该词的所有客观统计属性。但进入到核心的注意力匹配($d_k = 128$)时:
- 编程大模型(CodeLlama / DeepSeek-Coder):
它的注意力头被训练得极度对焦“底层逻辑”。投影出的 128 维特征全是:[是否涉及内存地址: 0.99, 是否容易导致段错误: 0.95, 情感色彩: 0.00]。 - 结果:模型在 $d_k$ 空间里迅速把 "Pointer" 与 "Memory"、"Array" 关联起来,准备开始 Debug。
- 文学写作大模型(Claude / Kimi):
它的注意力头更关注“修辞与情感纽带”。投影出的 128 维特征变成了:[是否具备隐喻特征: 0.88, 动作指向性: 0.85, 计算机属性: 0.01]。 - 结果:模型在 $d_k$ 空间里把 "Pointer" 理解成了“命运的指针”或“指引方向的风筝线”,准备开始写小说。
个人理解,$d_{\text{model}}$到注意力层($W_K$ 矩阵)维度转换,其实就是将主观、精准地投射到各自擅长的观察维度($d_k$)上。d_model 是一组维度,然后用这组维度去评估数据在 d_k 一组维度上的概率。
1.2、注意力机制的核心公式
标准 Attention 的计算完全基于三个矩阵:Q(Query,查询)、K(Key,键)、V(Value,值)。这三个矩阵是通过输入向量(Token Embeddings)乘以三个不同的权重矩阵 $W_Q, W_K, W_V$ 得到的。
数学表达式非常简洁:
$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V$
其中:
- $Q \in \mathbb{R}^{N \times d_k}$ ($N$ 为序列长度,$d_k$ 为特征维度)
- $K \in \mathbb{R}^{N \times d_k}$
- $V \in \mathbb{R}^{N \times d_v}$
- $\sqrt{d_k}$ 是缩放因子,用于防止点积结果过大导致 Softmax 的梯度消失。
1.3、标准 Attention 的四大计算步骤
假设我们输入一个序列长度为 $N$ 的文本(例如 $N=4$ 个单词),标准 Attention 的矩阵运算在硬件(如 GPU)中是按照以下顺序逐步执行的:
步骤一:计算相似度分数(MatMul 1)
首先,让 Query 矩阵与 Key 矩阵的转置相乘:
$S = QK^T$
- 物理意义: 这个操作让序列中的每一个单词去和所有单词做点积,计算它们之间的相关性。
- 矩阵形状: 得到一个 $N \times N$ 的中间矩阵 $S$(称为 Attention Score 矩阵)。
步骤二:缩放(Scale)与掩码(Mask,可选)
将得到的相似度分数矩阵除以 $\sqrt{d_k}$:
$S_{\text{scaled}} = \frac{S}{\sqrt{d_k}}$
如果是解码器(Decoder)阶段,为了防止当前位置看到未来的信息,还会在此处加入一个上三角掩码矩阵(Causal Mask),将未来位置的分数设为 $-\infty$。
为什么要缩放?
如果在中间不减去最大值(即完全省去缩放,等同于减去0),直接计算 $e^S$:
- 在注意力机制计算中,$S=QK^T$ 的数值很容易达到几十甚至上百。
- 在 GPU 的浮点数表示中:
- FP16(半精度)在指数超过 11.0(即 $e^{11}$≈59874)时就会发生数值上溢(Overflow)。
- BF16/FP32 在指数超过约 88.7 时也会彻底溢出。
- 如果不通过高频的中间最大值来压制指数,计算会瞬间崩溃,得到一堆非法的
NaN(Not a Number)。
步骤三:计算概率分布(Softmax)
对矩阵的每一行进行 Softmax 归一化操作:
$P = \text{softmax}(S_{\text{scaled}}) = \frac{e^{x_i - m}}{\sum e^{x_j - m}}$,其中$m = \max(S_i)$
- 物理意义: 将分数转化为 $[0, 1]$ 之间且每行总和为 1 的概率分布。这就得到了注意力权重矩阵(Attention Weights),代表每个单词对其他单词的关注度。
- 矩阵形状: 依然是 $N \times N$ 的矩阵 $P$。
步骤四:加权求和(MatMul 2)
最后,用注意力权重矩阵 $P$ 乘以 Value 矩阵 $V$:
$O = PV$
- 物理意义: 根据计算出的权重,把所有单词的特征信息(Value)进行加权求和,得到融合了上下文信息的新表征。
- 矩阵形状: 最终输出矩阵 $O$ 的形状为 $N \times d_v$,与输入形状一致。
1.4、标准 Attention 的致命缺陷:$O(N^2)$ 墙
标准 Attention 的做法在逻辑上非常完美,但在硬件实现(尤其是 GPU 运行)上存在两个严重的瓶颈。这也正是为什么后来会出现 FlashAttention 的原因:
1. 显存开销呈二次方爆炸(Memory Bound)
在步骤一和步骤三中,系统必须在显存中显式地创建并保存那个 $N \times N$ 的中间矩阵 $S$ 和 $P$。
- 如果序列长度 $N = 1,000$,矩阵大小为 $1,000 \times 1,000 = 10^6$(百万级元素)。
- 如果序列长度扩展到长文本的 $N = 100,000$(100k),矩阵大小直接飙升到 $100,000 \times 100,000 = 10^{10}$(百亿级元素)。
- 仅这一个中间矩阵就会吃掉数十 GB 的显存,直接导致 GPU 显存溢出。
2. 频繁的 HBM 显存读写
在 GPU 实际执行时:
- 从 HBM(全局显存)读取 $Q$ 和 $K$,计算出 $S$,然后写回 HBM。
- 从 HBM 读取 $S$,在片上 SRAM 做 Softmax,算出 $P$,再写回 HBM。
- 从 HBM 读取 $P$ 和 $V$,计算出 $O$,最后写回 HBM。
简而言之,片上缓存(SRAM)的带宽比显存(HBM)快了一个数量级,标准的 Attention 没有将 shared memory 最大化利用。
二 FlashAttention-1
标准 Attention 的死穴在于频繁读写慢速的 HBM(显存),来回搬运 $N \times N$ 的巨大中间矩阵。而 FlashAttention 的核心思想是:绝不显式计算这个 $N \times N$ 的大矩阵,全程利用 GPU 内部极快但极小的 SRAM(片上缓存),分块(Tiling)把 Attention 算完。
以下按发布时间整理的 NVIDIA 历代主要计算/数据中心 GPU 的显存(HBM/GDDR)容量与片上 SRAM 容量对比表:
年份 | GPU 架构 | 核心代表型号 | 显存 (HBM/GDDR) | SM 数量 | 单 SM SRAM(L1/Shared Mem) | 片上 SRAM 总容量(SM SRAM + L2 Cache) |
2016 | Pascal | Tesla P100 (SXM2) | 16 GB HBM2 | 56 | 64 KB | ~7.5 MB(3.5 MB L1/Shared + 4 MB L2) |
2017 | Volta | Tesla V100 (SXM2) | 16 / 32 GB HBM2 | 80 | 128 KB | ~16 MB(10 MB L1/Shared + 6 MB L2) |
2020 | Ampere | A100 (SXM4) | 40 / 80 GB HBM2e | 108 | 192 KB | ~60.75 MB(20.75 MB L1/Shared + 40 MB L2) |
2022 | Hopper | H100 (SXM5) | 80 GB HBM3 | 132 | 228 KB (可配置至256KB) | ~80 MB(30 MB L1/Shared + 50 MB L2) |
2023 | Hopper | H200 (SXM5) | 141 GB HBM3e | 132 | 228 KB (可配置至256KB) | ~80 MB(30 MB L1/Shared + 50 MB L2) |
2024 | Hopper | H20 (SXM5) | 96 GB HBM3 | 78 | 228 KB (可配置至256KB) | ~78 MB(~17.8 MB L1/Shared + 60 MB L2) |
2024 | Blackwell | B200 (双Die封装) | 192 GB HBM3e | 148 × 2 = 296 | 256 KB | ~201.6 MB(75.6 MB L1/Shared + 126 MB L2) |
2025/2026 | Blackwell Ultra | B300 / GB300 | 288 GB HBM3e | 148 × 2 = 296 | 256 KB | ~201.6 MB(75.6 MB L1/Shared + 126 MB L2) |
以下是 FlashAttention-1 的核心运作过程:
2.1、核心思想:分块(Tiling)与在线 Softmax(Online Softmax)
面对长文本(如 $N=100k$),大矩阵塞不进几十 MB 的 SRAM。FlashAttention 采用了两层嵌套循环,将大矩阵切成小方块:
- 外层循环(Outer Loop):遍历 $K$ 和 $V$ 的分块。
- 内层循环(Inner Loop):遍历 $Q$ 的分块。
遇到的数学拦路虎:Softmax 分母依赖全局
标准 Softmax 公式 $\frac{e^{x_i}}{\sum e^{x_j}}$ 要求必须知道整行的所有数据,才能算出分母。分块后,AI 每次只看一小段,怎么算 Softmax?传统的 Attention 之所以会在长文本时导致显存溢出,是因为它在数学上要求“必须看完一整行数据,才能算出这一行的结果”。而 FlashAttention 通过数学公式的恒等变形,打破了这个魔咒,实现了“看一块、算一块、扔一块”。
2.2、为什么标准 Softmax 无法分块?
在标准 Attention 中,对于第 $i$ 个 Query 向量,它与所有 Key 计算出的相似度分数为 $S_i = [s_{i1}, s_{i2}, \dots, s_{iN}]$。
为了防止自然指数 $e^x$ 爆炸(数值溢出),在做 Softmax 时通常会减去这一行的最大值 $m$。
标准计算公式如下:
- 找全局最大值:
$m = \max(S_i)$
- 算指数并求和:
$l = \sum_{j=1}^{N} e^{s_{ij} - m}$
- 算最终概率并乘 $V$:
$\text{Output}_i = \sum_{j=1}^{N} \frac{e^{s_{ij} - m}}{l} v_j$
问题在于必须把这 $N$ 个 $s_{ij}$ 全部算出来存在显存里,才能找到那个全局最大值 $m$ 和全局分母 $l$。如果矩阵太大塞不进 SRAM,就只能频繁向外存 HBM 读写。
为什么标准 Attention 不能直接通过矩阵分块直接计算?
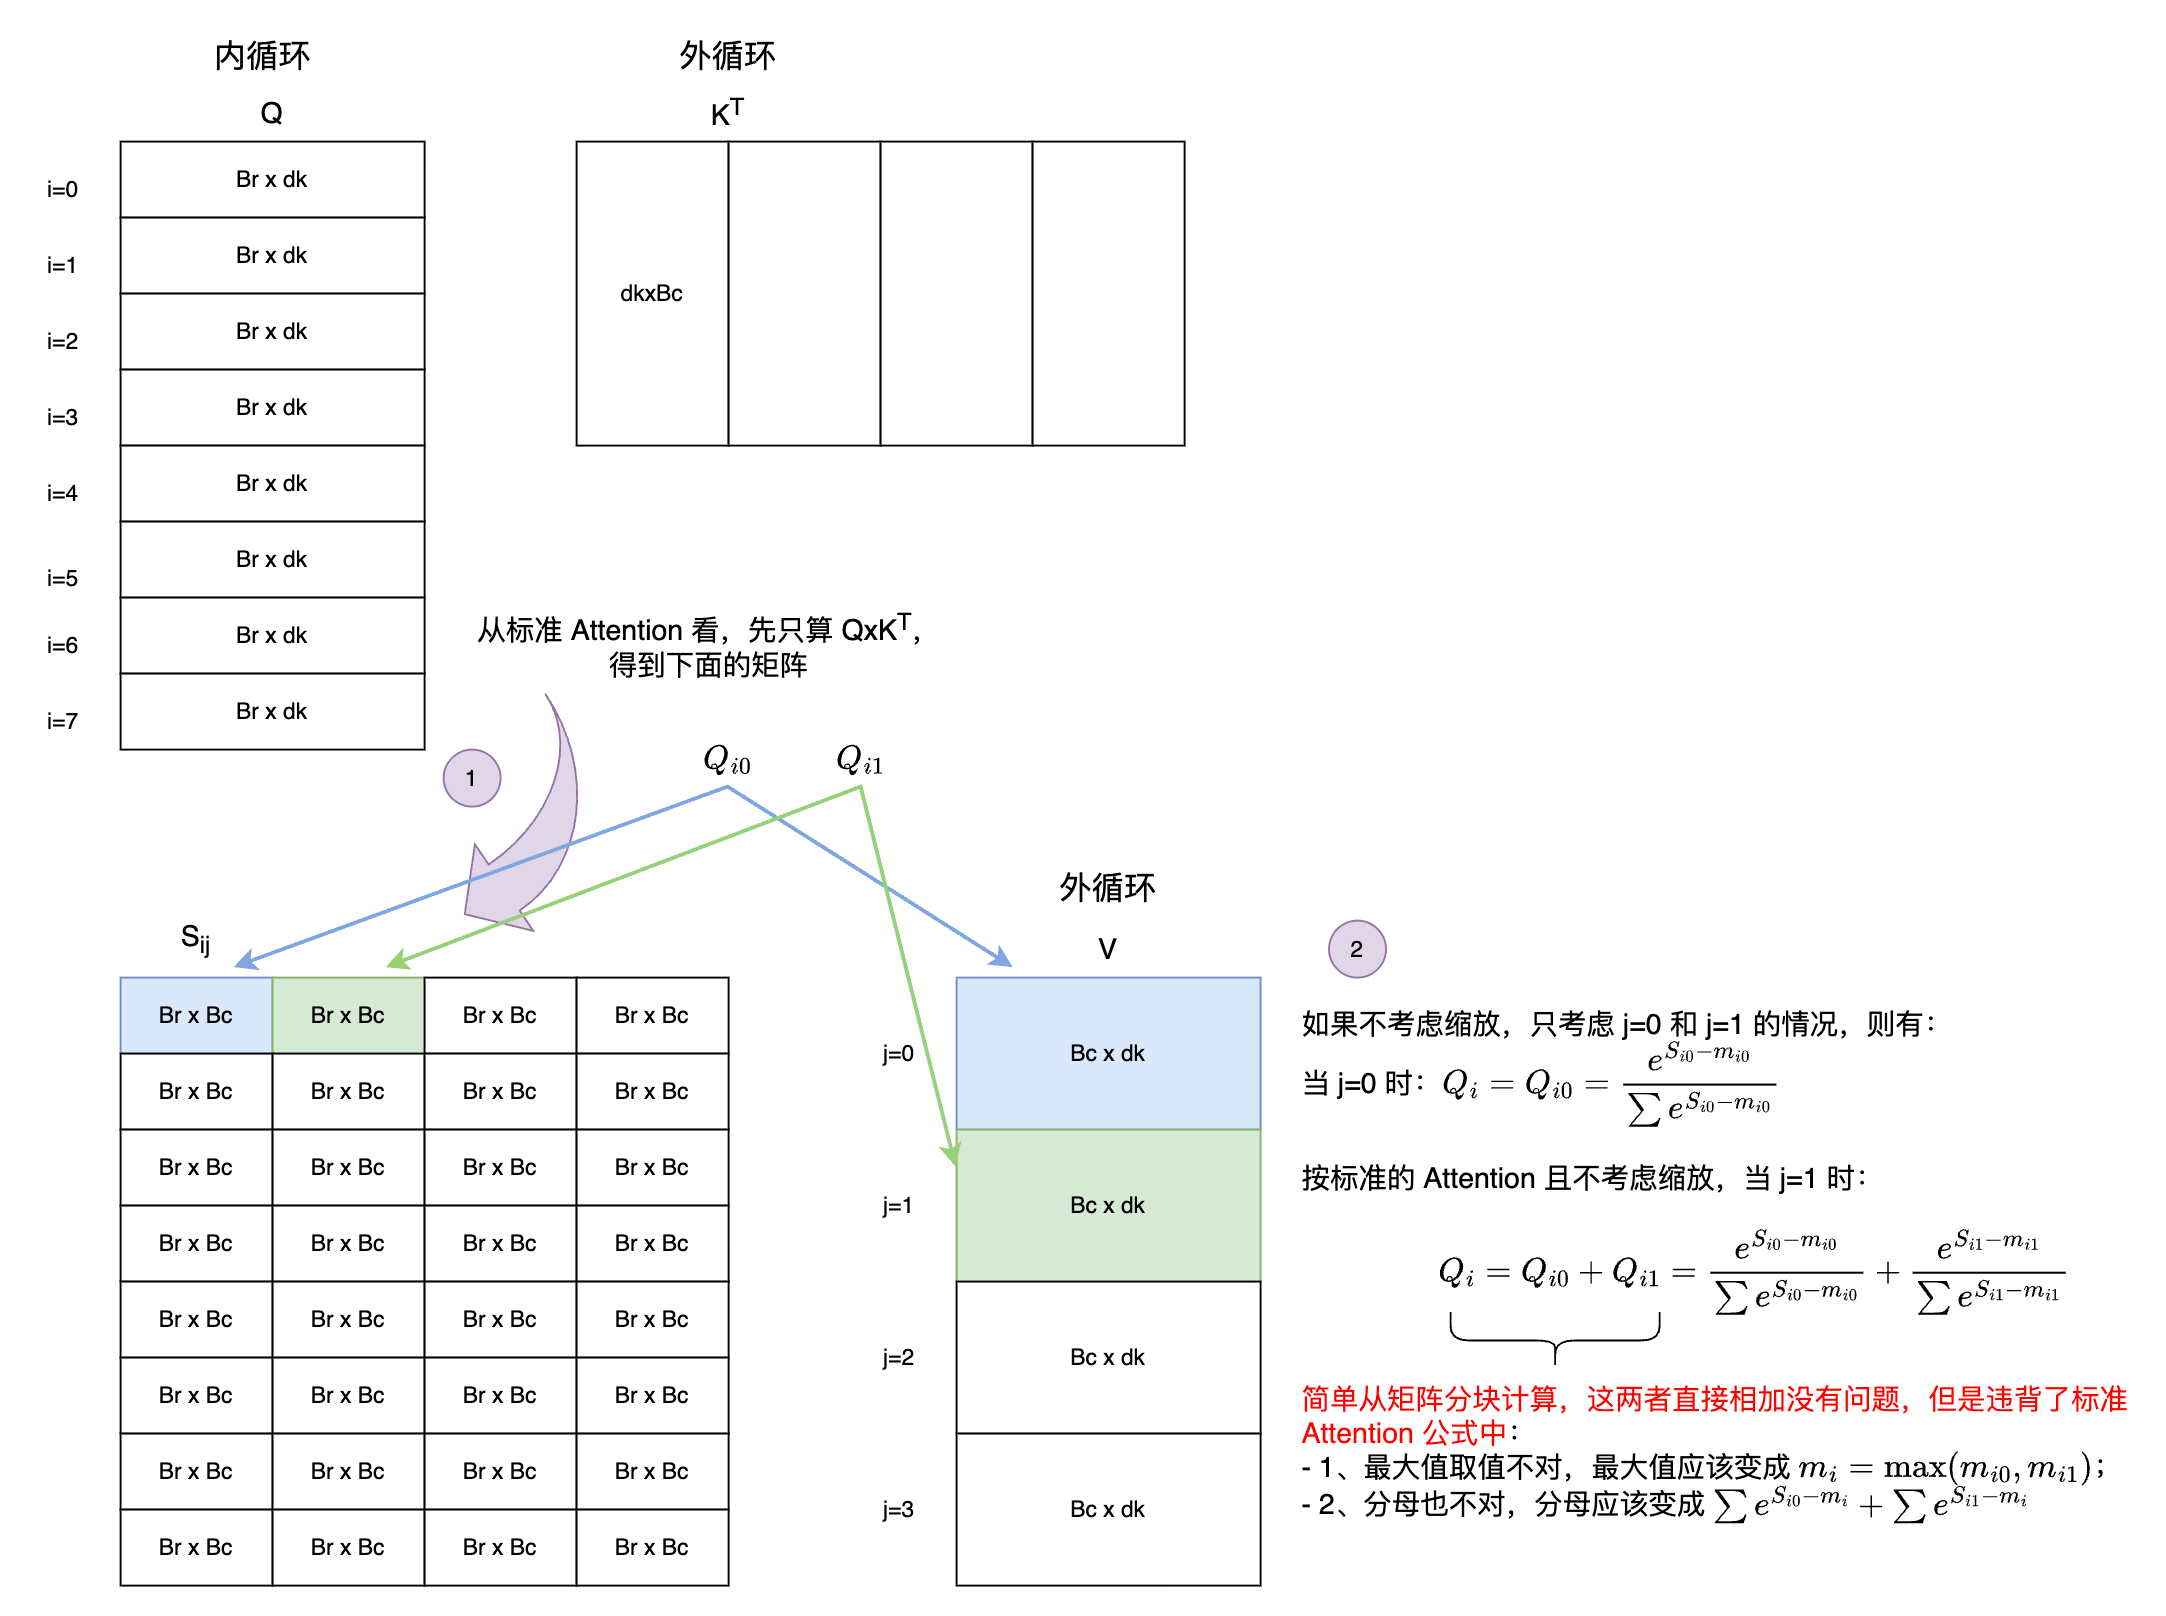
上面的示意图其实就是为了说明,按照标准的 Attention,最大值$m_{ij}$不是该行全局最大值,分块算是,分子也不符合标准 Attention 中 softmax 公式。综上,光分块还不行,还必须缩放。
2.3、FA-1 数学推导
FlashAttention-1 的核心贡献,就是利用局部变量去“拼凑”出全局结果。
在执行前,硬件会在 HBM(慢速显存)中开辟好 $O$(输出)、$l$(分母和)、$m$(最大值)的初始空间。
第一阶段:外层循环(遍历上下文 $K, V$)
硬件指针 $j$ 从 $1$ 开始,一直走到 $T_c$(列块总数)(注:第一次外循环不需要做等比例缩放)。
- 物理动作:内存控制器发出指令,将第 $j$ 块的 $K_j$ 和 $V_j$ 从 HBM 中拷贝到高速的 SRAM(片上共享内存)中。
- 驻留状态:在接下来的整个内层循环期间,这两个块将死死钉在 SRAM 里,供所有的 $Q$ 轮流查阅。
第二阶段:内层循环(遍历查询请求 $Q$)
硬件指针 $i$ 从 $1$ 开始,一直走到 $T_r$(行块总数)。这是算力与内存交互最密集的地方。
帧 1:加载 $Q$:从 HBM 中读取 $Q_i$ 块进入 SRAM。
由于是一代算法,必须同时把上次算到一半的 $O_i$、历史最大值 $m_i$、历史分母 $l_i$ 一并从 HBM 读进 SRAM。
帧 2:Tensor Cores 火力全开(第一轮):调用矩阵乘法单元,在 SRAM 内部生成一个局部的打分方阵 $S_{ij} = Q_i K_j^T$。
帧 3:寻找局部最大值与指数和:调用 CUDA Cores (非矩阵单元),扫描局部方阵,算出当前块的最大值和未归一化的权重。
- $\tilde{m}_{ij} = \text{rowmax}(S_{ij})$,$\tilde{m}_{ij} \in \mathbb{R}^{B_r \times 1}$
- $\tilde{P}_{ij} = e^{S_{ij} - \tilde{m}_{ij}}$
- $\tilde{l}_{ij} = \text{rowsum}(\tilde{P}_{ij})$
中间矩阵的大小就是$B_r \times B_c$。
帧 4:融合(Online Softmax 核心):在 SRAM 中用极其微小的标量寄存器,完成历史状态量与当前状态量的对齐。
真正的魔法来了! 现在有了两组局部数据,怎么合并成全局数据?
因为指数运算有一个极好的数学特性:$e^{x - a} = e^{x - b} \cdot e^{b - a}$。
直接算出全局最大值:
$m_i^{\text{new}} = \text{rowmax}(m_i, \tilde{m}_{ij})$,$m_i$可以理解记录的第 i 个分块的行最大值矩阵
利用这个新的全局最大值,去按比例缩放(Rescale)之前旧的 $l$ 和 $O$:
- 读取上一块$l_i$和当前块的$\tilde{l}_{ij}$的更新全局指数和:
$$ l^{(1)} = \sum e^{S^{(1)} - m^{(1)}} = \sum (e^{S^{(1)} - m^{(new)}}) (e^{m^{new} - m^{(1)}}) \to \sum (e^{S^{(1)} - m^{(new)}}) = e^{m^{(1)} - m^{(new)}} l^{(1)} \\ l^{(2)} = \sum e^{S^{(2)} - m^{(2)}} = \sum (e^{S^{(2)} - m^{(new)}}) (e^{m^{new} - m^{(2)}}) \to \sum (e^{S^{(2)} - m^{(new)}}) = e^{m^{(2)} - m^{(new)}} l^{(2)} $$
推导出:
$l^{\text{new}} = e^{m^{(1)} - m^{\text{new}}} l^{(1)} + e^{m^{(2)} - m^{\text{new}}} l^{(2)}$
同理可得:
$l_i^{\text{new}} = e^{m_i - m_i^{\text{new}}} l_i + e^{\tilde{m}_{ij} - m_i^{\text{new}}} \tilde{l}_{ij}$
注:
- 为什么$l_i^{\text{new}}$的公式中,有$l_i$和$\tilde{l}_{ij}$求和的关系?图 1 可以解释这个问题。如果只分块不考虑缩放,$Q_{i0}$和$Q_{i1}$ 的分母是各自的,但按照标准 Attention,分母理论上应该是:$\sum e^{S_{i0} - m_i} + \sum e^{S_{i1} - m_i}$(算每个$l$时,是不需要考虑$V_j$)。
- 为什么分子和分母($l_i^{\text{new}}$)可以分开计算?答案还是在图 1 中,结合上面的问题可理解。
帧 5:修正输出:第一次外循环结束后,$O_i$只有$O_{i0}$组成,但是当第二次外循环时,$O_i$只有$O_{i0}$和$Q_{i1}$组成,同时,在第二次外循环中,$O_{i0}= \frac{e^{s_{i0} - m_{i0}}}{l_{i0} = \sum e^{S_{i0} - m_{i0}}}V_0$需要按比例纠正。
将旧的 $O_i$ 按比例缩小,同时让 $\tilde{P}_{ij}$ 乘以 $V_j$(矩阵乘法),两者相加,得到更新后的半成品 $O_i^{\text{new}}$。
按照标准的 Attention,分块后,分子理论上应该是:
$\text{最新分子} = \sum_{\text{old}} e^{S_{\text{old}} - m_i^{\text{new}}} V_{\text{old}} \quad + \quad e^{S_{\text{new}} - m_i^{\text{new}}} V_j$
但是,我们需要用历史的$O_i$和当前块的$\tilde{O}_{ij}$表示最新的$O^{new}_i$,推导过程如下:
推论 1(历史归一化输出): $$ O_i = \frac{1}{l_i} \sum_{\text{old}} e^{S_{\text{old}} - m_i} V_{\text{old}} \to \sum_{\text{old}} e^{S_{\text{old}} - m_i} V_{\text{old}} = l_i O_i $$
推论 2(当前块):$\tilde{O}_{ij} = e^{S_{\text{new}} - \tilde{m}_{ij}} V_j = \tilde{P}_{ij} V_j$
- 将上面理论上最新分子公式(全局视角的未归一化特征总和)展开成两部分计算:纠正历史块和当前分块
$\text{最新分子} = \sum_{\text{old}} e^{S_{\text{old}} - m_i^{\text{new}}} V_{\text{old}} \quad + \quad e^{S_{\text{new}} - m_i^{\text{new}}} V_j$
这两部分可以分开计算:
纠正历史块:
$\sum_{\text{old}} e^{(S_{\text{old}} - m_i) + (m_i - m_i^{\text{new}})} V_{\text{old}} = e^{m_i - m_i^{\text{new}}} \underbrace{\sum_{\text{old}} e^{S_{\text{old}} - m_i} V_{\text{old}}}_{推论1的 l_i O_i} = e^{m_i - m_i^{\text{new}}} l_i O_i$
纠正当前分块:
$e^{(S_{\text{new}} - \tilde{m}_{ij}) + (\tilde{m}_{ij} - m_i^{\text{new}})} V_j = e^{\tilde{m}_{ij} - m_i^{\text{new}}} \underbrace{e^{S_{\text{new}} - \tilde{m}_{ij}} V_j}_{推论2的 \tilde{P}_{ij} V_j} = e^{\tilde{m}_{ij} - m_i^{\text{new}}} \tilde{P}_{ij} V_j$
最新分子,要想得到完美的最新输出 $O_i^{\text{new}}$,只需将其除以最新的分母 $l_i^{\text{new}}$:
$$ \begin{align} \text{最新分子} & = \sum_{\text{old}} e^{S_{\text{old}} - m_i^{\text{new}}} V_{\text{old}} \quad + \quad e^{S_{\text{new}} - m_i^{\text{new}}} V_j \\ & = (l_i e^{m_i - m_i^{\text{new}}}) O_i + (e^{\tilde{m}_{ij} - m_i^{\text{new}}}) \tilde{P}_{ij} V_j \\ \end{align} \\ \Downarrow \\ \begin{align} O_i^{\text{new}} & = \frac{(l_i e^{m_i - m_i^{\text{new}}}) O_i + (e^{\tilde{m}_{ij} - m_i^{\text{new}}}) \tilde{P}_{ij} V_j}{l_i^{\text{new}}} \\ & = \left( \frac{l_i e^{m_i - m_i^{\text{new}}}}{l_i^{\text{new}}} \right) O_i + \left( \frac{e^{\tilde{m}_{ij} - m_i^{\text{new}}}}{l_i^{\text{new}}} \right) \tilde{P}_{ij} V_j \end{align} \\ $$
最后,因为括号里算出来的是一维的缩放系数向量,而后面的 $O_i$ 和 $\tilde{P}_{ij} V_j$ 是二维矩阵,为了在数学表达上实现严谨的“按行相乘”,我们给标量系数套上对角化函数 $\text{diag}$,最终公式大功告成:
$$ \begin{align} O_i^{\text{new}} & = \text{diag}\left(\frac{l_i e^{m_i - m_i^{\text{new}}}}{l_i^{\text{new}}}\right) O_i + \text{diag}\left(\frac{e^{\tilde{m}_{ij} - m_i^{\text{new}}}}{l_i^{\text{new}}}\right) \tilde{P}_{ij} V_j \\ & = \text{diag}(l_i^{\text{new}})^{-1}( \text{diag}(l_i) e^{m_i - m_i^{\text{new}}} O_i + e^{\tilde{m}_{ij} - m_i^{\text{new}}} \tilde{P}_{ij} V_j) \\ \end{align} $$
帧 6:写回 HBM
因为 SRAM 空间有限,必须把刚刚更新好的半成品 $O_i^{\text{new}}$、$m_i^{\text{new}}$、$l_i^{\text{new}}$ 强行写回 HBM,以便给下一个 $Q_{i+1}$ 腾出工作台位置。
(内层循环结束,回到帧 1 处理下一个 $Q_i$)
个人理解:只要处理完一次外循环,一个完整的$O$其实已经出现,而后面的外循环其实是在不断叠加新并且修正已有的$O$,每次内循环在修正对应分块的大小。
最后:当双层循环全部跑完,HBM 里的状态就是:
$$ \text{完整的输出矩阵 } O = \begin{bmatrix} O_1 \\ O_2 \\ \dots \\ O_{Tr} \end{bmatrix} $$
硬件无需做任何额外的复杂融合,只要把这些跑完全程的 $O_i$ 块按原本的行号在 HBM 里上下堆叠,最终的输出矩阵 $O$ 就自然形成了。
整体算法流程:
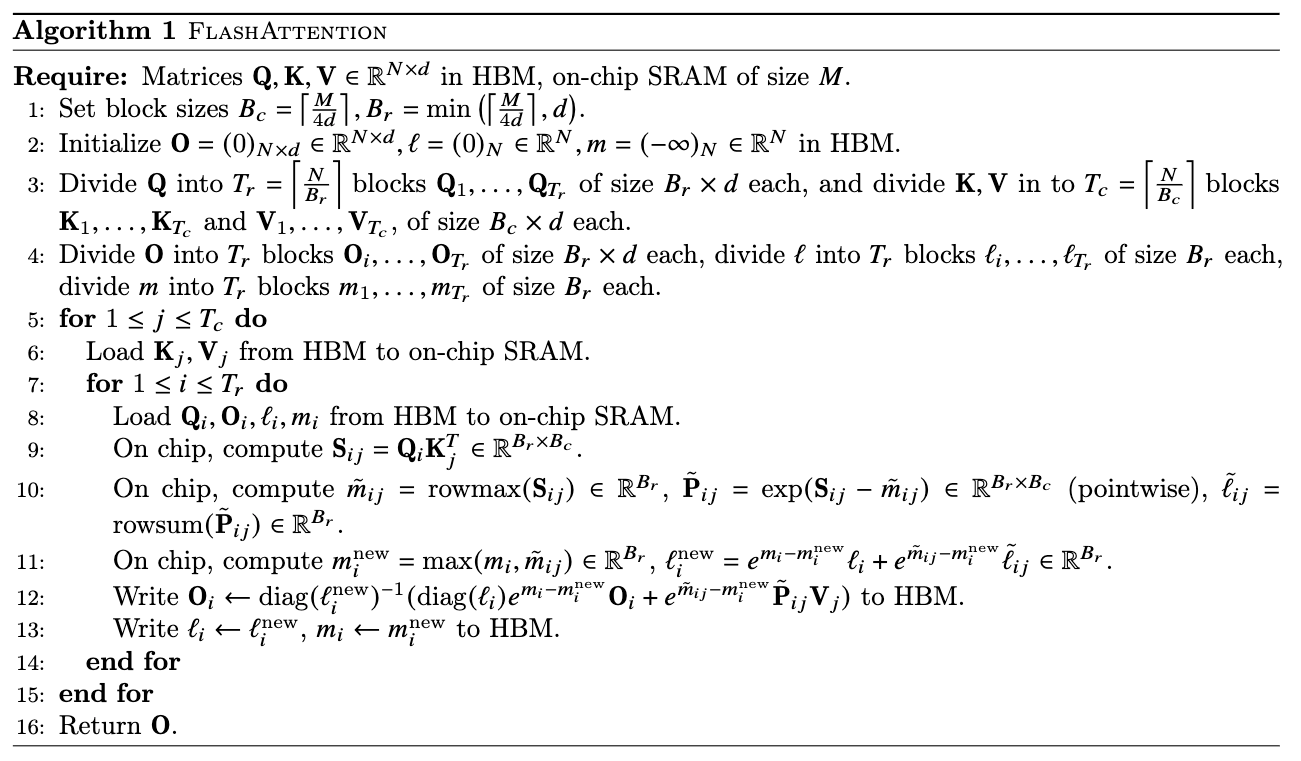
推导结论: 通过维护 $(m, l, O)$ 这三个动态状态量,我们完美实现了:每次只读一小块矩阵,不断修正历史结果。这使得 $O(N^2)$ 的中间张量彻底从硬件上消失了。
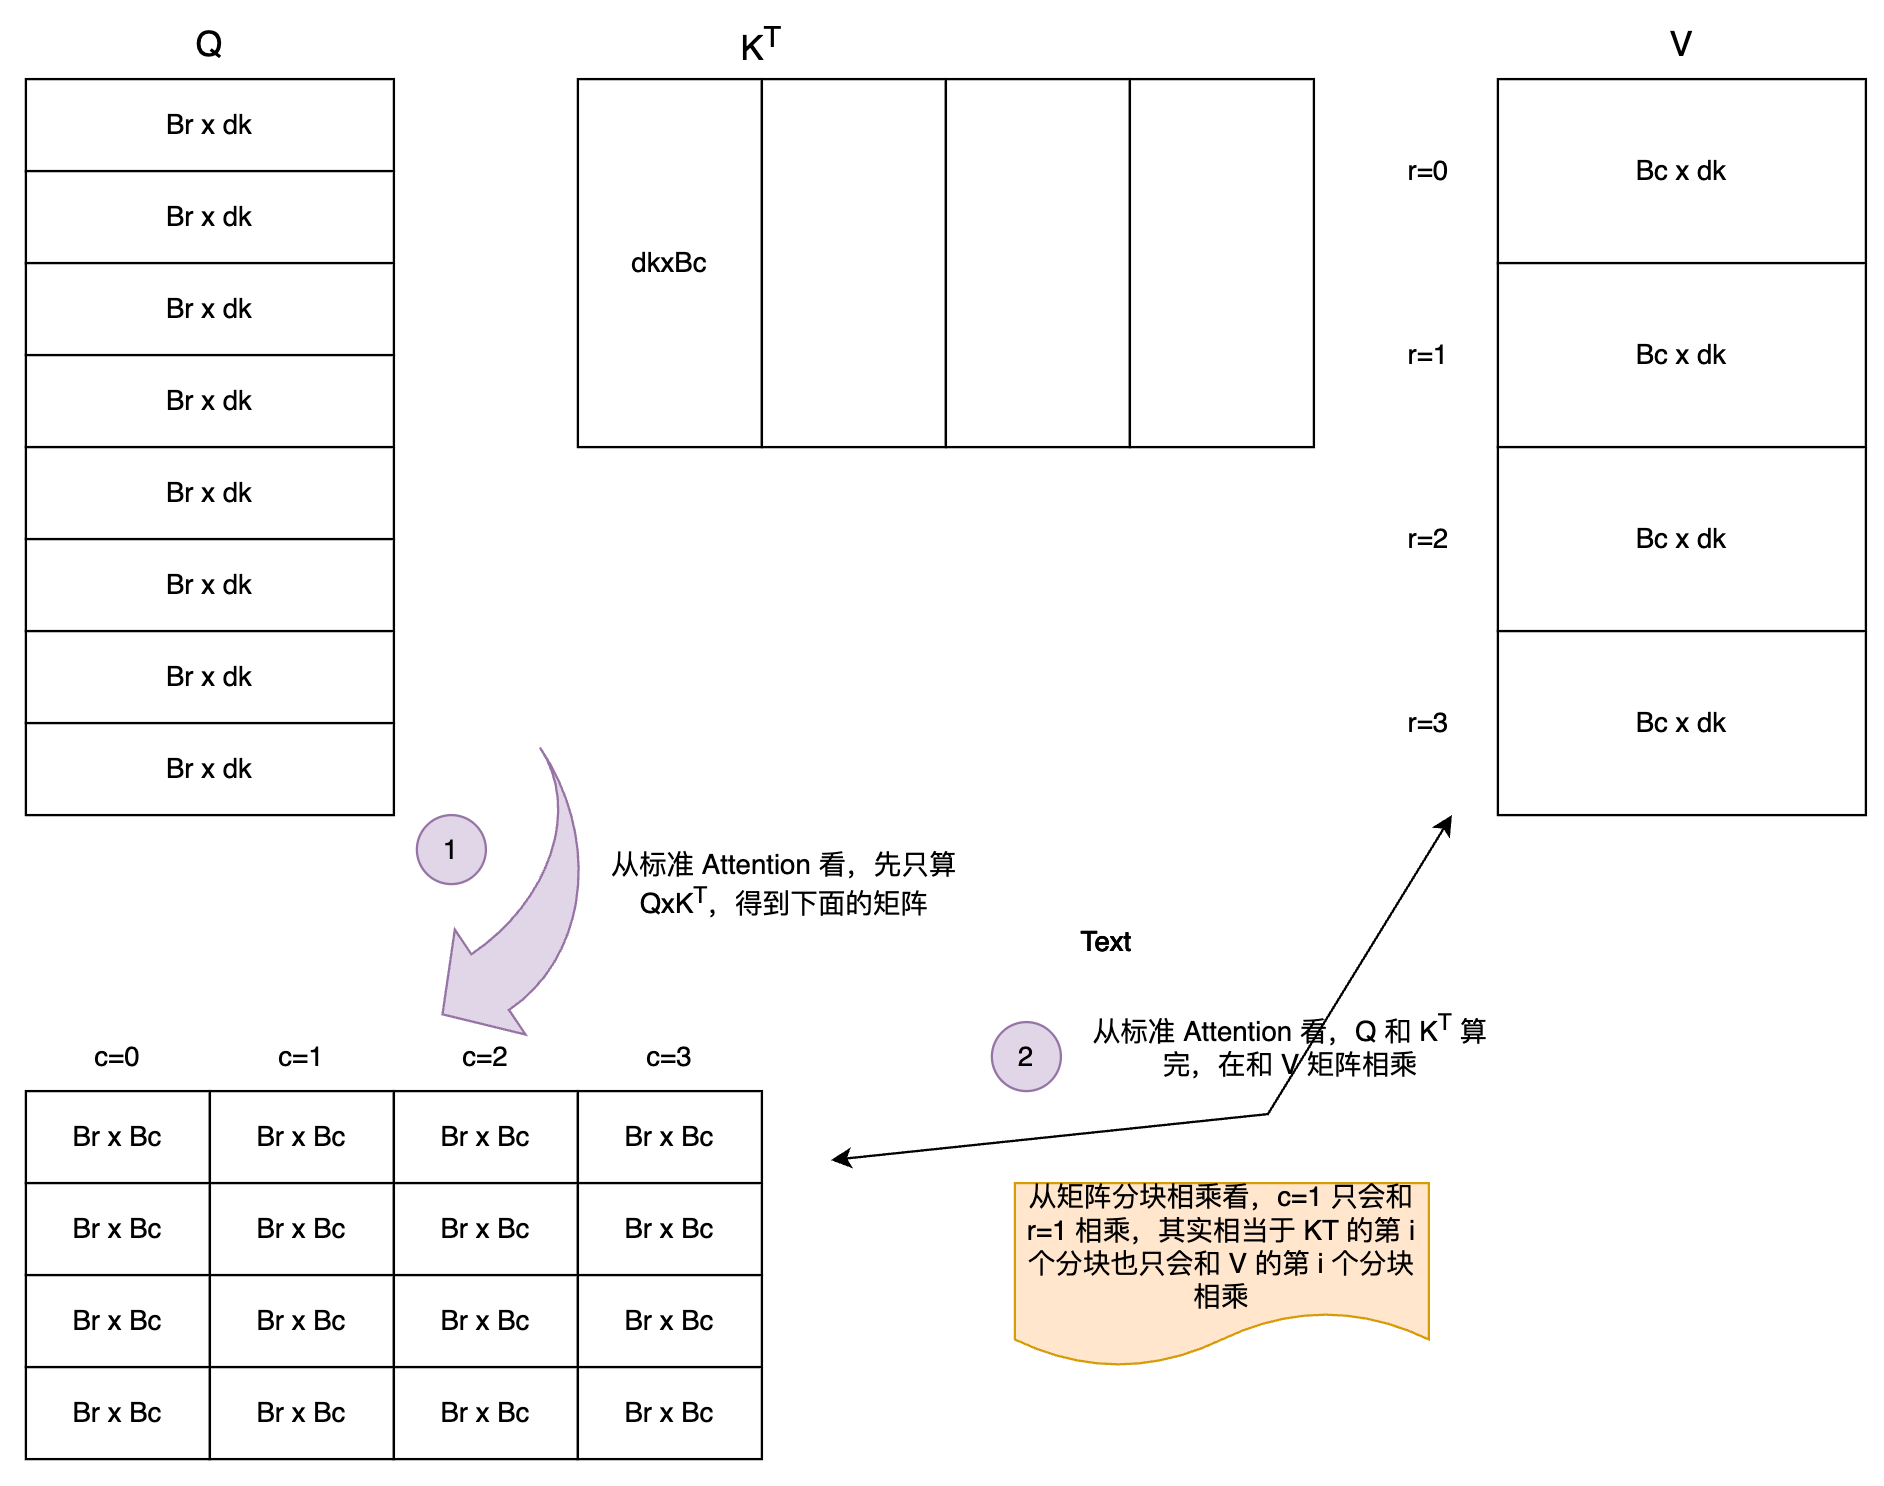
小思考:
- 为什么只需要两层循环而不是三层循环,比如 V 还需要添加一个最顶层循环?按矩阵分块的思想,K^T 纵向的第 i 个分块只会和 V 横向第 i 个分块先乘。
图 3
2.4、FA-1 IO复杂度
在 GPU 上的真实算法流水线如下:
- 初始化: 在 HBM 中开辟空间存放输出矩阵 $O$,并初始化 $l = 0, m = -\infty$。
- 外层循环 (Outer Loop): 遍历 $K$ 和 $V$ 的分块(例如按 128 列为一块)。
- 内层循环 (Inner Loop): 遍历 $Q$ 的分块。
- 片上计算:
- 从 HBM 载入当前块 $Q_i, K_j, V_j$ 到 SRAM。
- 计算局部 $S = Q_i K_j^T$。
- 使用上述的 Online Softmax 公式,更新当前的 $m_i, l_i, O_i$。
- 将更新后的 $O_i, l_i, m_i$ 写回 HBM。
两次循环需要的 HBM 带宽( FlashAttention 论文中那个 $O(\frac{N^2 d^2}{M})$ 复杂度的计算过程):
第 1 步:定义物理变量
在开始算账之前,我们先定义好矩阵和切块的物理参数:
- $N$:序列长度(Sequence Length)。
- $d$:注意力头的特征维度(Head Dimension)。
- $M$:SRAM(共享内存)的总大小。
- $B_c$:$K$ 和 $V$ 的切块大小(每次取多少个 Token),列块数 $T_c = \frac{N}{B_c}$(例如$B_c$取 128)。
- $B_r$:$Q$ 和 $O$ 的切块大小(每次取多少个 Token),行块数 $T_r = \frac{N}{B_r}$(例如$B_r$取 64)。
注:为了计算核心复杂度,我们忽略 $l_i, m_i$ 这两个一维向量带来的极小内存开销(它们的大小是 $O(N)$,而矩阵是 $O(Nd)$,完全可以忽略不计)。
第 2 步:外层循环的 HBM 搬移量
外层循环负责遍历 $K$ 和 $V$ 的列块。
- 循环次数:一共跑 $T_c$ 次。
- 单次操作:从 HBM 读入一个 $K_j$ 块(大小为 $B_c \times d$)和一个 $V_j$ 块(大小为 $B_c \times d$,例如 d 取 128)。
- 单次搬移量:$2 \times B_c \times d$。
外层循环总搬移量 = 循环次数 $\times$ 单次搬移量
$\text{HBM}_{\text{outer}} = T_c \times (2 B_c d) = \frac{N}{B_c} \times 2 B_c d = 2Nd$
物理意义:在整个 Attention 计算过程中,完整的 $K$ 矩阵和 $V$ 矩阵被且仅被读取了 1 次。
第 3 步:内层循环的 HBM 搬移量
内层循环负责遍历 $Q$ 的行块,但请注意,它是嵌套在外层循环里面的!
- 总执行次数:外层跑 $T_c$ 次,内层每次跑 $T_r$ 次。所以内层一共执行了 $T_c \times T_r$ 次。
- 单次读操作:读入一个 $Q_i$ 块($B_r \times d$),还要把上次写回的输出累积块 $O_i$($B_r \times d$)重新读出来。单次读搬移量 = $2 \times B_r \times d$。
- 单次写操作:算完当前部分后,必须把更新后的输出块 $O_i$($B_r \times d$)写回 HBM 给下一次外层循环备用。单次写搬移量 = $B_r \times d$。
- 内层单次总搬移量 = $3 \times B_r \times d$。
内层循环总搬移量 = 总执行次数 $\times$ 单次搬移量
$\text{HBM}_{\text{inner}} = (T_c \times T_r) \times (3 B_r d)$
我们将 $T_r = \frac{N}{B_r}$ 代入:
$\text{HBM}_{\text{inner}} = T_c \times \frac{N}{B_r} \times 3 B_r d = 3Nd \times T_c = \frac{3N^2d}{B_c}$
物理意义:由于外层循环切换了 $\frac{N}{B_c}$ 次,导致 $Q$ 和 $O$ 这两个矩阵,被反复在 HBM 和 SRAM 之间倒腾了 $\frac{N}{B_c}$ 次!
第 4 步:最终表达式与复杂度推导
把内外层加起来,FlashAttention-1 的 HBM 内存访问总量(读+写)的精确表达式为:
$\text{Total HBM Access (FA-1)} = 2Nd + \frac{3N^2d}{B_c}$
为什么论文里说是 $O(\frac{N^2 d^2}{M})$?
在第一代 FlashAttention 中,为了把 $K,V,Q,O$ 刚好塞进 SRAM(大小为 $M$),硬件层面的最优块大小配置是 $B_c = \Theta(\frac{M}{d})$。
把 $B_c$ 代入总搬移量表达式的第二项:
$\text{核心 HBM 开销} = \frac{3N^2d}{M / d} = \frac{3N^2d^2}{M}$
所以,FlashAttention 的理论 I/O 复杂度就是 $O(\frac{N^2 d^2}{M})$。
2.5、为什么还要升级?FlashAttention-1 的三大不足
如果你仔细审视上面的一代流程,会发现它在工程实现上埋下了几个极大的性能隐患,这也正是 FlashAttention-2 重点开刀的地方:
缺陷一:极其糟糕的内外循环顺序(引发 HBM 流量海啸)
在 FlashAttention-1 的设计中,外层循环是 $K,V$,内层循环是 $Q$。每次固定一个 $K,V$ 块,我们要拿所有的 $Q$ 块去和它乘一遍。这意味着,对于每一个 $Q$ 块,它的局部状态量 $(m_i, l_i, O_i)$ 每走一步,都必须被写回 HBM,然后在下一个 $K,V$ 块到来时再从 HBM 读出来进行 Rescale。这导致 HBM 的读写次数依然偏高,远未达到理论下限。
缺陷二:非矩阵乘法(Non-matmul)指令过多
在上面的推导中,频繁出现了标量/向量乘法:$e^{m^{\text{old}} - m^{\text{new}}} \times O^{\text{old}}$。
GPU 里最强大的算力怪兽是 Tensor Cores(专门做大规模矩阵乘加)。但一代算法中保留了太多的指数运算、除法和按比例缩放,这些统统需要退回到普通的 CUDA Cores 去算。导致 Tensor Cores 一直在“等”标量计算做完,算力利用率(FLOPs/s)只能跑到硬件极限的 25%~40%。
缺陷三:并行动力不足(低入驻率)
FlashAttention-1 的并行切分层级非常高:它把任务分配给 GPU 线程块的维度是 [Batch Size $\times$ Heads 数]。
- 如果你跑的是一个长文本、小 Batch 的场景(比如 Batch=1,Heads=12),那么 GPU 最多只会启动 12 个 Thread Blocks 去干活。
- 像 A100 这种拥有 108 个 SM(流式多处理器)的巨兽,剩下的 96 个 SM 就会完全处于闲置挂机状态(Low Occupancy)。
缺陷四:Warp 级别的共享内存冲突
在一个 Thread Block 内部,一代算法对 $K, V$ 的数据切分方式会导致不同的 Warp(线程束)高频地去读写同一块 Shared Memory(片上共享内存),引发严重的 Bank Conflicts(内存库冲突) 和同步等待。
三 FlashAttention-2
3.1、为什么需要 FlashAttention-2?
虽然 FlashAttention-1 实现了惊人的显存节省(由二次方降为线性),但原作者 Tri Dao 发现它依然没能压榨干 GPU 的极限算力(在 A100 上仅达到理论性能的 25-40%)。原因有三点,这也正是 FlashAttention-2 针对性干掉的痛点:
问题1:非矩阵乘法(Non-matmul)算力浪费
在一代的 Online Softmax 算法中,由于外层循环遍历 $K, V$,内层循环遍历 $Q$,导致模型在每次迭代时,都需要高频地对输出矩阵 $O$ 进行 Rescale(乘以一个缩放系数)。这些繁琐的乘法和加法不属于 Tensor Cores 擅长的“矩阵乘法(GEMM)”,属于“通用计算(Non-matmul FLOPs)”,严重拖慢了芯片速度。
问题 2:多头并行的入驻率(Occupancy)危机
在一代中,程序主要是在多头(Heads)和批次(Batch Size)之间分配 GPU 的线程块(Thread Blocks)。
- 翻车场景:如果当前 Batch 极小(比如在线大模型单人推理 Batch=1),且头数不多(例如只有 8 个 $K$ 头)。A100 拥有 108 个 SM(流式多处理器),此时只有 8 个 SM 在干活,剩下的 100 个 SM 全部在摸鱼。
问题 3:线程束(Warps)之间的共享内存内耗
在一个 Thread Block 内部,包含多个协同工作的 Warp(线程束,每 32 个线程一组)。一代在拆分任务时,不同 Warp 之间需要高频地通过 Shared Memory(共享内存) 来互相读写、交换中间的乘法结果,引发了严重的 bank conflict(内存分块冲突)和等待延迟。
3.2、FA-2 数学推导
延迟缩放与 LogSumExp 补偿。
假设序列长度为 $N$,注意力头的特征维度为 $d$。片上高速缓存(SRAM)的容量决定了我们的切块大小:
- 行块(针对 $Q$ 和最终输出 $O$):切块大小为 $B_r$,将矩阵横向切分为 $T_r = \frac{N}{B_r}$ 块。
- 列块(针对 $K$ 和 $V$):切块大小为 $B_c$,将矩阵横向切分为 $T_c = \frac{N}{B_c}$ 块。
全局显存(HBM)状态:
在 HBM 中,我们存放输入矩阵 $Q, K, V$,并预留好两个输出空间:
- 最终的注意力输出矩阵 $O$。
- 专门用于反向传播的 LogSumExp 向量 $L$。
(绝不在 HBM 中为任何中间累加状态分配空间!)
3.2.1、外层循环(固定$Q_i$)
外层循环的指针是 $i$,从 $1$ 走到 $T_r$。
它的核心任务是在 SRAM 中建立一个坚固的“蓄水池”,让当前处理的 $Q_i$ 块安静地待在里面,吸收全局的上下文。
对于第 $i$ 步外层循环的开头:
- 载入查询请求:将 $Q_i \in \mathbb{R}^{B_r \times d}$ 从慢速的 HBM 读取到极速的 SRAM 中。
- 初始化“纯血状态量”:在 SRAM(或更快的寄存器)中,为当前 $Q_i$ 开辟三个累加器:
- 未缩放输出矩阵:$\tilde{O}_i = \mathbf{0}_{B_r \times d}$
- 指数分母总和:$l_i = \mathbf{0}_{B_r \times 1}$
- 局部最大值:$m_i = -\mathbf{\infty}_{B_r \times 1}$
3.2.2、内层循环(遍历 $K_j, V_j$块)
内层循环的指针是 $j$,从 $1$ 走到 $T_c$。
它的核心任务是把整句话的特征分批次读入,并通过“延迟缩放(Delayed Scaling)”的纯乘加数学魔法,无损地融合到 $\tilde{O}_i$ 中。
对于第 $j$ 步内层循环,硬件执行以下精确操作:
步骤 A:载入数据与计算局部打分
将当前切块 $K_j, V_j \in \mathbb{R}^{B_c \times d}$ 从 HBM 读入 SRAM。调用 Tensor Cores 计算局部打分方阵:
$S_{ij} = Q_i K_j^T$
步骤 B:寻找局部最大值并对齐全局基准
扫描刚刚算出的 $S_{ij}$,找出每一行的局部最大值 $\tilde{m}_{ij} = \text{rowmax}(S_{ij})$。立刻与 SRAM 中维护的历史最大值 $m_i$ 进行 PK,决出新的全局最大值:
$m_i^{\text{new}} = \max(m_i, \tilde{m}_{ij})$
步骤 C:纯乘加更新未缩放输出 $\tilde{O}_i$
为了避免除法拖慢 Tensor Cores,FA-2 直接对“未缩放分子”进行指数补偿和累加:
$\tilde{O}_i \leftarrow \text{diag}\left(e^{m_i - m_i^{\text{new}}}\right) \tilde{O}_i + e^{S_{ij} - m_i^{\text{new}}} V_j$
- 历史补偿项:将历史积攒的 $\tilde{O}_i$,按“新旧最大值之差”进行等比例衰减(纯乘法)。
- 当前新增项:计算当前块的未缩放特征并执行矩阵乘加(由于对齐了新基准,免疫指数溢出)。
步骤 D:同步更新分母和最大值状态
用同样的指数补偿逻辑,更新分母总和:
$l_i \leftarrow l_i \cdot e^{m_i - m_i^{\text{new}}} + \text{rowsum}\left(e^{S_{ij} - m_i^{\text{new}}}\right)$
最后,把全局最大值更新,为迎接下一个块做好准备:
$m_i \leftarrow m_i^{\text{new}}$
此时,单次内层迭代结束。硬件什么都不往 HBM 里写,直接去 HBM 拉取下一块 $K_{j+1}, V_{j+1}$。
3.2.3、外层循环的一次落盘
当内层循环走到 $j = T_c$ 时,驻留在 SRAM 里的 $Q_i$ 已经遍历了完整的$K, V$,它对应的 $\tilde{O}_i, l_i, m_i$ 已经吸收了全量信息。
此时,硬件跳出内层循环,回到外层循环的收尾阶段。执行最终的数学运算,并向 HBM 进行内循环唯一的写回:
核心计算 1:内循环唯一一次除法(最终归一化)
$O_i = \text{diag}(l_i)^{-1} \tilde{O}_i$
将完全归一化的 $O_i$ 写入 HBM 对应的空间。这就是前向传播的最终产物。
核心计算 2:计算 LogSumExp 向量(反向传播伏笔)
为了在反向传播时能瞬间重计算出精确的梯度概率,必须保存对数-指数和:
$L_i = m_i + \ln(l_i)$
将一维向量 $L_i$ 写入 HBM。有了它,反向传播只需执行$P = e^{S - L}$即可跳过复杂的归一化逻辑。
伪代码:
最后,外循环执行完成。全矩阵 $O$ 的垂直拼接。
3.3、FA-2 IO 复杂度
如何评估衡量 FlashAttention-2 的 IO 复杂度(HBM 读写字节)?
在渐进的 Big-O 复杂度上,FlashAttention-2 和 1 代是完全一样的,都是 $O(\frac{N^2 d^2}{M})$。
但为什么 FA-2 的实际运行速度能翻倍?下面是 FA-2 绝对精确的 IO 读写账单。
1. FA-2 的精确 IO 账本推导
我们依然设定:序列长度为 $N$,特征维度为 $d$。$Q$ 块大小为 $B_r$,$K,V$ 块大小为 $B_c$。
第一笔账:外层循环(遍历 $Q$)
- 循环次数:一共跑 $T_r = \frac{N}{B_r}$ 次。
- 单次操作:从 HBM 读入 $Q_i$(大小 $B_r \times d$)。在内循环彻底结束后,向 HBM 写入 $O_i$(大小 $B_r \times d$)和 $L_i$(大小 $B_r \times 1$,极小可忽略)。
- 单次搬移量:$2 B_r d$。
- 外层总搬移量 = $T_r \times (2 B_r d) = \frac{N}{B_r} \times 2 B_r d = \mathbf{2Nd}$。
第二笔账:内层循环(遍历 $K, V$)
- 总执行次数:外层跑 $T_r$ 次,内层每次跑 $T_c$ 次。总共执行 $T_r \times T_c = \frac{N}{B_r} \times \frac{N}{B_c}$ 次。
- 单次操作:从 HBM 纯流式读入 $K_j$(大小 $B_c \times d$)和 $V_j$(大小 $B_c \times d$)。没有任何 HBM 写入动作。
- 单次搬移量:$2 B_c d$。
- 内层总搬移量 = $\left(\frac{N}{B_r} \times \frac{N}{B_c}\right) \times 2 B_c d = \mathbf{\frac{2N^2d}{B_r}}$。
FA-2 最终 HBM 访问量公式
$\text{Total IO}_{\text{FA-2}} = 2Nd + \frac{2N^2d}{B_r}$
2. 对比:FA-1 vs FA-2
为了看出差距,我们把之前推导过的 FA-1 公式拿过来放在一起对比:
$$ \begin{align*} \text{Total IO}_{\text{FA-1}} &= 2Nd + \frac{3N^2d}{B_c} \\ \text{Total IO}_{\text{FA-2}} &= 2Nd + \frac{2N^2d}{B_r} \end{align*} $$
如果在极限情况下,假设内存分配的块大小相同($B_c \approx B_r = \Theta(\frac{M}{d})$),两者的理论复杂度确实都是 $\Theta(\frac{N^2d^2}{M})$。但 FA-2 实现了常数项直接砍掉 1/3:
- FA-1 内层循环的系数是 $3$(读 $Q$、读 $O$、写 $O$)。
- FA-2 内层循环的系数是 $2$(读 $K$、读 $V$)。
在 $N=8192$ 甚至更长的长文本推理中,公式的后半部分 $\frac{N^2d}{B}$ 占据了 95% 以上的流量,常数项从 3 变成 2,意味着绝对的 HBM 数据搬移总量硬生生减少了 33%。
3.4、总结:FlashAttention-1 vs FlashAttention-2 核心差异对比图
优化维度 | FA-1 (2022) | FA-2 (2023) | 性能收益 |
循环顺序 | 外层 K,V / 内层 Q | 外层 Q / 内层 K,V | $Q_i$ 从频繁读写 HBM 变成仅写回 1 次。 |
数学操作 | 每次循环都缩放输出并除以 $l$ | 追踪未缩放输出,仅在最后除 1 次 | 显著减少非矩阵乘法,Tensor Cores 利用率飙升。 |
并行维度 | Batch x Heads | Batch x Heads x Seq_len | 解决小 Batch/少头的低入驻率问题,GPU 全线满载。 |
Warp 分工 | 切分 K,V,需共享内存通信 | 切分 Q,各算各行,0 通信 | 消除共享内存 Bank Conflicts。 |
IO 复杂度 | $2Nd + \frac{3N^2d}{B_c}$ | $2Nd + \frac{2N^2d}{B_r}$ | |
极限速度 (A100) | ~25%-40% 硬件理论上限 | ~50%-73% 硬件理论上限 | 训练和长文本推理速度再次翻倍。 |
四 FlashAttention-3
在 FA-2 中,由于算力和访存的同步耦合,H100 极其恐怖的 FP16/FP8 算力被白白浪费(最高只能跑到 35% 左右的理论上限)。FA-3 论文的核心贡献,就是通过硬件级指令解耦(Warp-Group Specialization)、软件流水线(Ping-Pong Scheduling)以及块级低精度量化(Block-wise FP8),将利用率强行拔高到了 75%。
下面,我们对着论文的 Algorithm 1 和 Algorithm 2,把 FA-3 的执行流逐帧推平。
4.1、硬件底座:Hopper 架构的两把“妖刀”
要看懂 FA-3 的调度,必须先认识 H100 引入的两个全新硬件级异步指令。FA-3 的整个算法都是围绕它们设计的:
- TMA (Tensor Memory Accelerator):硬件级异步拷贝引擎。它可以独立于 SM(流式多处理器)内的线程运行。你只需要发一条指令,TMA 就会在后台自动把 HBM(全局显存)里的一个大 Block 搬到 Shared Memory(SRAM)中,搬完后触发一个 Barrier(屏障)通知你。
- WGMMA (Warp-Group Matrix-Multiply-Accumulate):Hopper 专属的异步矩阵乘法指令。它可以让 4 个 Warp(即 128 个线程组成的一个 Warp-Group)联合起来,直接从 Shared Memory 中读取数据,并在后台异步计算矩阵乘法,结果直接存入寄存器。
4.2、核心改进 1:Warp-Group 特化(Algorithm 1 拆解)
在 FA-2 中,每个 Warp 都在执行“读数据 $\rightarrow$ 计算 GEMM $\rightarrow$ 计算 Softmax”的串行循环。
在 FA-3 中,作者将一个 SM 内部的线程强制划分为不同的阶级,实现生产者-消费者模型。
假设我们分配 1 个 Warp-Group(128 线程)作为生产者,2 个 Warp-Group(256 线程)作为消费者。
4.2.1、生产者流(Producer Warp-Group)
生产者的代码极其枯燥,它的眼里只有 TMA,任务是填满 Shared Memory(SRAM)里的多重缓冲(Double/Triple Buffering)。
// 伪代码:FA-3 生产者线程流
void producer_loop() {
    for (int j = 0; j < Tc; ++j) {
        // 计算当前要填入 SRAM 的 Buffer 索引 (Ping-Pong)
        int buf_idx = j % 2;

        // 发送 TMA 指令:异步将 K_j 和 V_j 从 HBM 搬到 SRAM[buf_idx]
        tma_copy_async(SRAM_K[buf_idx], HBM_K[j]);
        tma_copy_async(SRAM_V[buf_idx], HBM_V[j]);

        // 发出指令后,立刻进入下一次循环去搬下一块,绝不等待!
    }
}
4.2.2、消费者流(Consumer Warp-Group)
消费者绝对不碰 HBM,它们只盯着 SRAM,并且疯狂调用异步指令。
// 伪代码:FA-3 消费者线程流
void consumer_loop() {
    for (int j = 0; j < Tc; ++j) {
        int buf_idx = j % 2;

        // 1. 等待 TMA 屏障:确保 SRAM[buf_idx] 里的 K, V 已经就绪
        wait_for_tma_barrier(buf_idx);

        // 2. 发送异步 WGMMA 指令:计算 S = Q * K^T
        // 注意:这里是异步的,发出后 Consumer 可以立刻去干别的!
        wgmma_async(S_ij, Q_i, SRAM_K[buf_idx]);

        // 3. 等待 WGMMA 算完 S_ij
        wait_for_wgmma();

        // 4. 调用 CUDA Cores 计算 Softmax 缩放 (这里其实被 Ping-Pong 调度重叠了,详见下文)
        compute_softmax_and_scale_O(S_ij, ...);

        // 5. 发送异步 WGMMA 指令:计算 O = P * V
        wgmma_async(O_i, P_ij, SRAM_V[buf_idx]);
    }
}
算法过程:
4.3、核心改进 2:Ping-Pong 调度与指令级重叠 (Overlapping)
论文中最硬核的部分,是解决 Consumer 内部的卡顿。
WGMMA是由 Tensor Cores 执行的。Softmax(指数运算、最大值寻找)是由普通 CUDA Cores 执行的。
如果在循环里写 WGMMA(算 S) -> Softmax -> WGMMA(算 O),Tensor Cores 和 CUDA Cores 就会互相等待,流水线依然是断裂的。
FA-3 的“魔法重排”(Ping-Pong Scheduling):
FA-3 将循环展开,让当前块的非矩阵乘法(Softmax)与下一个块的矩阵乘法(GEMM)在时间上重叠。
在物理硬件上,它的执行时间轴是这样的:
- 消费者发出指令:异步计算块 0 的 $S_0 = Q \times K_0^T$。
- 拿到 $S_0$ 后,计算块 0 的 $P_0$ 和最大值 $m$。
- 发出指令:异步计算块 0 的 $O_0 = P_0 \times V_0$。
- 发出指令:异步计算块 1 的 $S_1 = Q \times K_1^T$。 (注意!这里 Tensor Cores 开始全力算块 1 了)。
- 【重叠发生区】:在 Tensor Cores 疯狂算块 1 的 $S_1$ 和块 0 的 $O_0$ 的同时,CUDA Cores 利用这段时间,把刚刚算完的 $O_0$ 拿出来,乘以指数衰减系数,进行缩放对齐(Rescaling)。
- 循环往复。
通过这种重新排序,FA-3 让极其耗时的 Softmax 指数缩放操作,变成了躲在 WGMMA 异步阴影下的“零耗时”操作。
4.4、核心改进 3:原生 FP8 支持与非相干处理 (Incoherent Processing)
H100 的 FP8 算力高达 1.98 PFLOPS。但如果直接把 FA-2 的代码换成 FP8,模型会当场崩溃(精度爆炸)。因为 FP8 的动态范围极小,而 LLM 的激活值里存在大量的 Outliers(异常大值)。
论文中,FA-3 为了完美吃下 FP8,从数学层面做了两项大手术:
4.4.1、块级量化 (Block-wise Quantization)
在标准的 FP8 计算中,整个矩阵共享一个缩放因子 (Scale Factor)。但在 FA-3 中,由于计算是分块(Block)进行的,局部块内的最大值 $\tilde{m}_{ij}$ 波动极大。
FA-3 强制要求在每个 SRAM 块的级别维护独立的量化缩放系数。
当 $\tilde{O}_i$ 在寄存器中完成 FP32 的累加后,只有在被写出或者参与下一轮 WGMMA 之前,才会被局部量化回 FP8/FP16,从而把量化误差限制在了一个极小的 [Br, Bc] 块内。
4.4.2、非相干处理 (Incoherent Processing / Hadamard Transform)
这是 FA-3 论文中解决 Outliers 的杀手锏。
既然 LLM 的特征维度里有极个别的“刺头(极其大的异常值)”,那我们在计算 Attention 之前,先把所有的 $Q$ 和 $K$ 矩阵乘以一个随机的正交矩阵(例如随机符号 Hadamard 矩阵) $R$。
在数学上,Attention 分数不变:
$S = (Q R) (K R)^T = Q R R^T K^T = Q K^T$
(因为正交矩阵 $R R^T = I$)
但在物理上发生了质变:乘以 Hadamard 矩阵等价于在特征空间做了一次均匀的“旋转散射”。原本集中在某一个维度上的巨大异常值,被均匀地平摊到了所有维度上。此时所有的数值都变得非常“乖巧”,可以直接用 FP8 进行无损量化,Tensor Cores 得以火力全开。
4.5、总结:FA-3 究竟带来了什么?
FlashAttention-1 和 2 是在与 Memory Bandwidth (内存带宽) 作斗争。
FlashAttention-3 则是默认内存带宽已经被降服,开始与 Instruction Scheduling (指令级调度) 和 Tensor Core Utilization (张量核心利用率) 作斗争。
它通过 TMA 和 WGMMA 剥离了 IO 与 Compute,通过 Ping-Pong 调度隐藏了 Softmax,通过 Hadamard 散射解决了 FP8 溢出。最终,它在 H100 上达成了前向 1.2 PFLOPS 的逆天性能,成为了目前最顶级的底层算力压榨模板。
五 Flashattention-4
FlashAttention-4 主要是为了应对 NVIDIA Blackwell 架构(如 B200 和 GB200 GPU)中的非对称硬件扩展(Asymmetric Hardware Scaling)而设计的。在 Blackwell 架构中,Tensor Core 的矩阵乘法(MMA)吞吐量翻倍,但共享内存(SMEM)带宽和指数运算单元(MUFU)等非矩阵乘法资源却扩展缓慢或保持不变,导致这些非 MMA 资源成为了新的性能瓶颈。
相比于之前主要针对 Hopper 架构(H100)优化的 FlashAttention-3,FlashAttention-4 引入了以下几个维度的核心创新:
1. 硬件与流水线层面的重构(Pipeline Redesign)
- 重构流水线以最大化重叠:Forward 和 Backward 流水线被重新设计,充分利用 Blackwell 的完全异步 MMA 操作与更大的 Tile 尺寸(Blackwell 为 128×128,而 Hopper 为 64×128)。这使得 Tensor Core、Softmax 计算与内存搬运(TMA)之间的并行重叠达到了最大化。
- 利用张量内存(Tensor Memory, TMEM):Blackwell 引入了 256 KB 的片上 TMEM,紧密耦合于 Tensor Core 且不占用寄存器。FlashAttention-4 将中间结果(如 $S$ 和 $P$ 矩阵、累加器等)写入 TMEM,极大地缓解了 Hopper 时代内核面临的寄存器溢出压力,并支持了更大尺寸的分块(Tile)。
2. 缓解非矩阵乘(Non-Matmul)瓶颈
- 软件模拟指数函数(Software-Emulated Exp):Blackwell 硬件指数单元(MUFU)吞吐极低,成为 Softmax 的致命瓶颈。FlashAttention-4 在 FMA(乘加)单元上利用多项式逼近(Cody-Waite 技术)软件模拟了 $2^x$ 指数函数,让 FMA 与 MUFU 并行工作,极大地提升了指数吞吐。
- 部分混合模拟(Partial Emulation):由于软件模拟会增加寄存器压力,FlashAttention-4 仅将一行内 10%–25% 的输入交由 FMA 软件模拟,其余仍由硬件
MUFU.EX2执行,在吞吐量与寄存器资源之间取得了完美平衡。 - 有条件的 Softmax 重缩放(Conditional Rescaling):在线 Softmax 更新时,通常每步都要进行向量乘法重缩放以防数值溢出。FlashAttention-4 引入了带有“容差(Slack)”的有条件重缩放,仅当两步的最大值差值 mj − mj-1 超过设定阈值 $\tau$(通常设为 8.0)时才执行重缩放,否则跳过,并在最后进行一次统一的规范化修正。这大幅减少了 Forward 阶段的向量计算开销。
3. 反向传播流量与全局原子加优化(Backward Pass)
- 2-CTA MMA 协同模式:由于反向传播极其消耗共享内存带宽,FlashAttention-4 启用了 Blackwell 的 2-CTA MMA 模式,由同一集群内的两个 CTA 协同执行单个 MMA,每个 CTA 只需要暂存一半的 B 操作数,使 B 矩阵的共享内存读取和级搬运流量减半。
- dQ 步骤原子加减半:2-CTA 的拆分会导致在 $dQ$ 累加轴上的冲突。FlashAttention-4 通过分布式共享内存(DSMEM)在两个 CTA 之间交换一半的 $dS$,使每个 CTA 仅负责计算并全局原子写入半个 $dQ$ 分块,不仅避免了通信停顿,更将昂贵的全局原子减少(Global Atomic Reduction)次数直接减半,并大大提升了反向传播的确定性表现。
- 极致的确定性反向传播模式(Deterministic Mode):为了方便强化学习等场景调试,FlashAttention-4 提供了确定性执行模式。通过结合 batch/head 维度交错(Swizzling)、因果掩码下的最长/最短处理时间优先(LPT/SPT)调度,在严格保证数值确定性的同时,其运行速度能够达到非确定性 1-CTA 版本的 75%。
4. 更加智能的 Tile 调度策略(Scheduling)
- 可变长度与因果掩码的 LPT 调度:因果掩码和可变序列长度(Varlen)天然存在计算负载不均的问题。FlashAttention-4 采用最长处理时间优先(Longest-Processing-Time-First, LPT)算法。在 Varlen 场景下通过预处理内核在运行时对 Batch 按最大执行时间进行虚拟排序,在 Causal 场景下通过头与 Batch 的多维交错规整,最大限度减少了多 SM 间的负载倾斜,并提高了 L2 缓存的命中率。
5. 开发框架与编译创新
- 基于 Python 内嵌 CuTe-DSL 实现:FlashAttention-4 放弃了以前极度复杂的 C++ 模板元编程,选择完全在 Python 内嵌的 CuTe-DSL 中编写。这不仅确保了算子依然能够下发到底层 PTX/SASS 级别进行精确的硬件控制(全表达力),同时通过 JIT 即时编译,将单个 Forward 算子的编译时间从 55秒 缩短至 2.5秒,编译速度提升了 20-30 倍。
5.1 FlashAttention-3 无法在 Blackwell 架构运行
FlashAttention-3 无法在 Blackwell 架构的 B200 GPU 上运行,主要有以下两个核心原因:
1. 缺乏 Hopper MMA 指令的前向兼容性
FlashAttention-3 是专门针对 NVIDIA Hopper 架构(如 H100 GPU)设计和深度优化的。它在底层严重依赖了 Hopper 特有的异步 WGMMA 矩阵乘累加(MMA)指令。然而,Blackwell 硬件平台缺乏对这些 Hopper 专属 MMA 指令的前向兼容性,这导致直接在 B200 上加载和执行 FlashAttention-3 的内核代码变得完全不可能。
2. 底层硬件架构与寄存器/内存设计的巨大差异
即使排除指令兼容性问题,简单地将上一代算法移植到新硬件上也无法有效运行。Blackwell 架构引入了与 Hopper 迥异的非对称硬件扩展和新特性:
- 分块尺寸变化:Blackwell 的单个 MMA 硬件指令处理的分块(Tile)尺寸为 128×128 元素,而 Hopper 的分块尺寸仅为 64×128。
- 张量内存(TMEM)的引入:Blackwell 引入了 256 KB 的片上张量内存(TMEM),其 Tensor Core 操作直接将结果异步写入 TMEM,而不是像 Hopper 那样写入寄存器或严重依赖共享内存(SMEM)。
- 瓶颈的根本性转移:Blackwell 的 Tensor Core 算力相比 Hopper 翻倍,但共享内存(SMEM)带宽和指数运算单元(MUFU)的吞吐量却扩展缓慢或保持不变,导致非矩阵乘(Non-Matmul)操作成为了新的主要瓶颈。
为了应对这些底层指令的不兼容性并解决全新出现的硬件瓶颈,研究团队推出了针对 Blackwell 架构(B200 & GB200)进行算法与流水线重构的 FlashAttention-4。
参考
https://mp.weixin.qq.com/s/pWC6dq2MJZgRBCnRttKCFg